Dvě stránky, které si web sestavil sám ze sebe
Až dosud ti tento engine uměl ukázat deset příspěvků najednou a nic jiného. /page/128/ je na velkém archivu skutečná adresa a neřekne ti nic o tom, jestli jsi přistál v roce 2009 nebo 2014 – stránkování je ukotvené od nejstaršího příspěvku, takže se ti číslo pod nohama pohne pokaždé, když se něco publikuje. Jediný úplný seznam čehokoli žil v terminálu.
1.5 přidává dvě stránky, které archiv čtou, místo aby jím procházely.
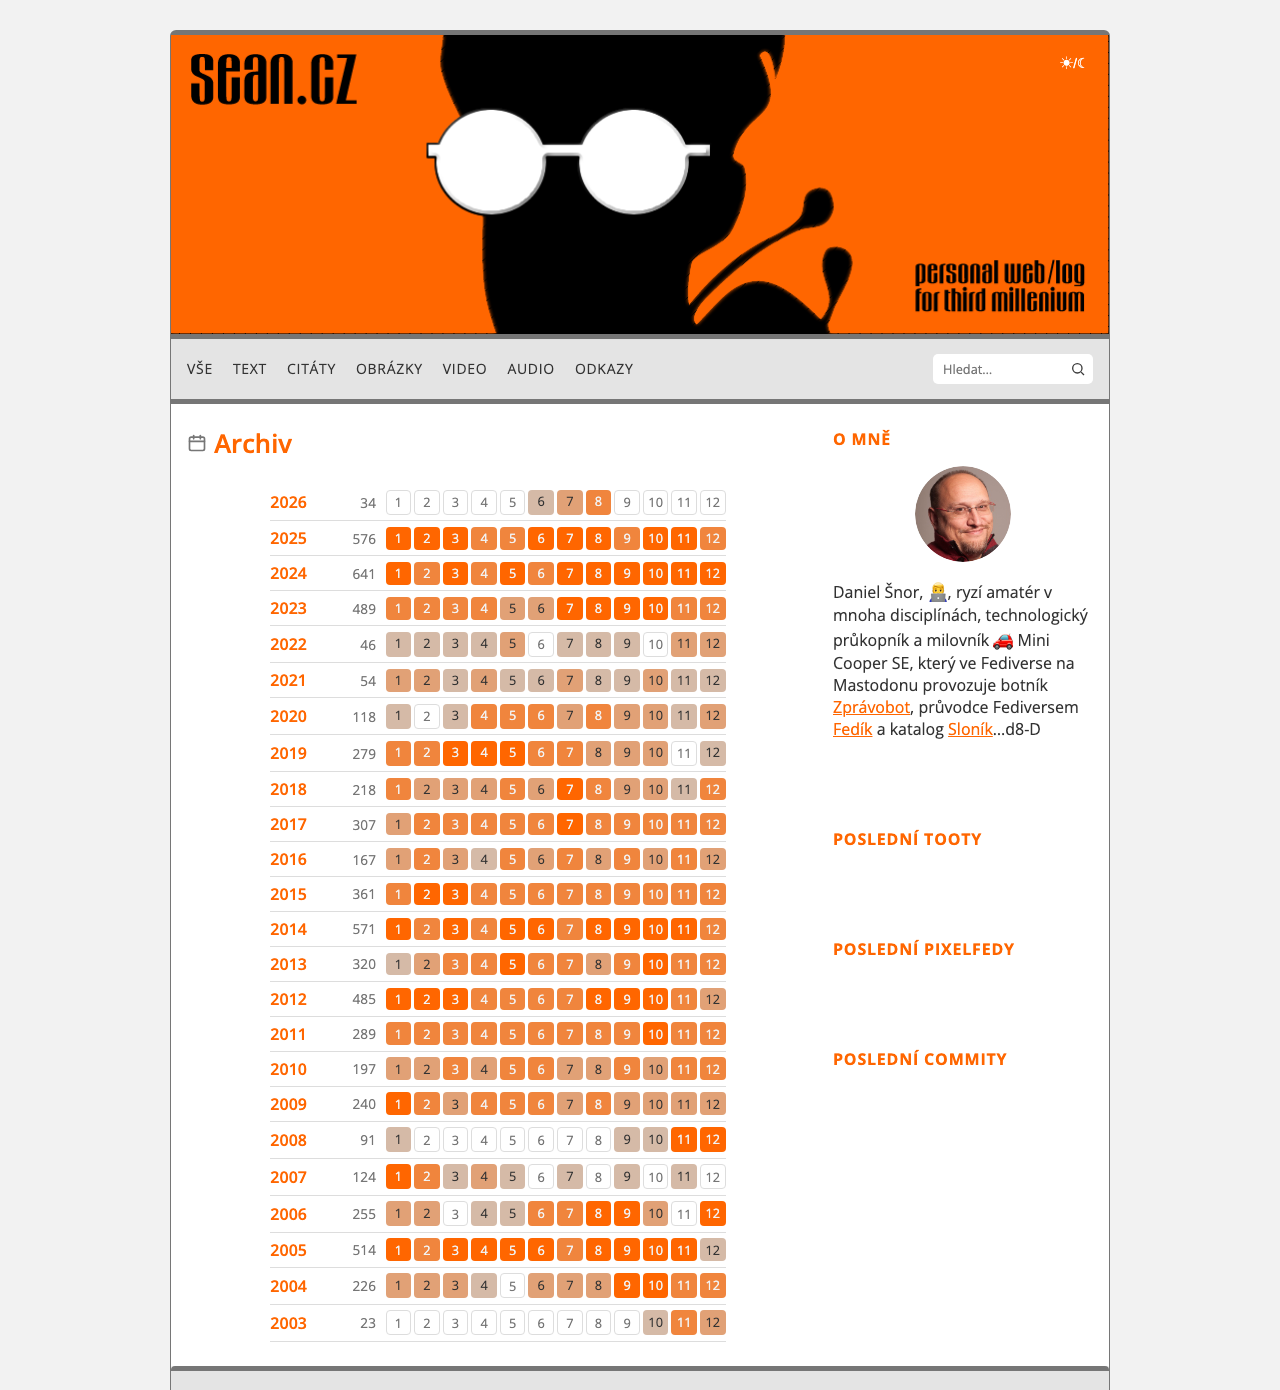
/archive/ – tvar celku
Řádek na rok a vedle něj pás dvanácti měsíců. Měsíc je vystínovaný v jednom ze čtyř stupňů, ne jen rozsvícený nebo tmavý, protože „má příspěvky / nemá" není otázka, na kterou stojí za to odpovídat: na referenčním archivu drží měsíc kdekoli mezi jedním příspěvkem a sedmaosmdesáti, a kreslit je stejně by skrylo to jediné, k čemu mapa je. /archive/<rok>/ je jeden řádek na příspěvek, po měsících.
Dvě úrovně a víc ne. Třetí by byla nějakých 280 stránek jednotlivých měsíců – hodně sestavování na otázku, kterou nikdo nepoložil.
Je to rejstřík, ne další výpis: žádné úryvky, žádné obrázky, žádné karty. A je levný už stavbou. Publikace příspěvku přepíše mapu a běžný rok; rok 2014 se od silvestra 2014 nezměnil a nikdy nezmění, takže nasazení, které porovnává obsah, pro něj nemá co nahrát, už nikdy.
/tag/ – každé téma, které web má
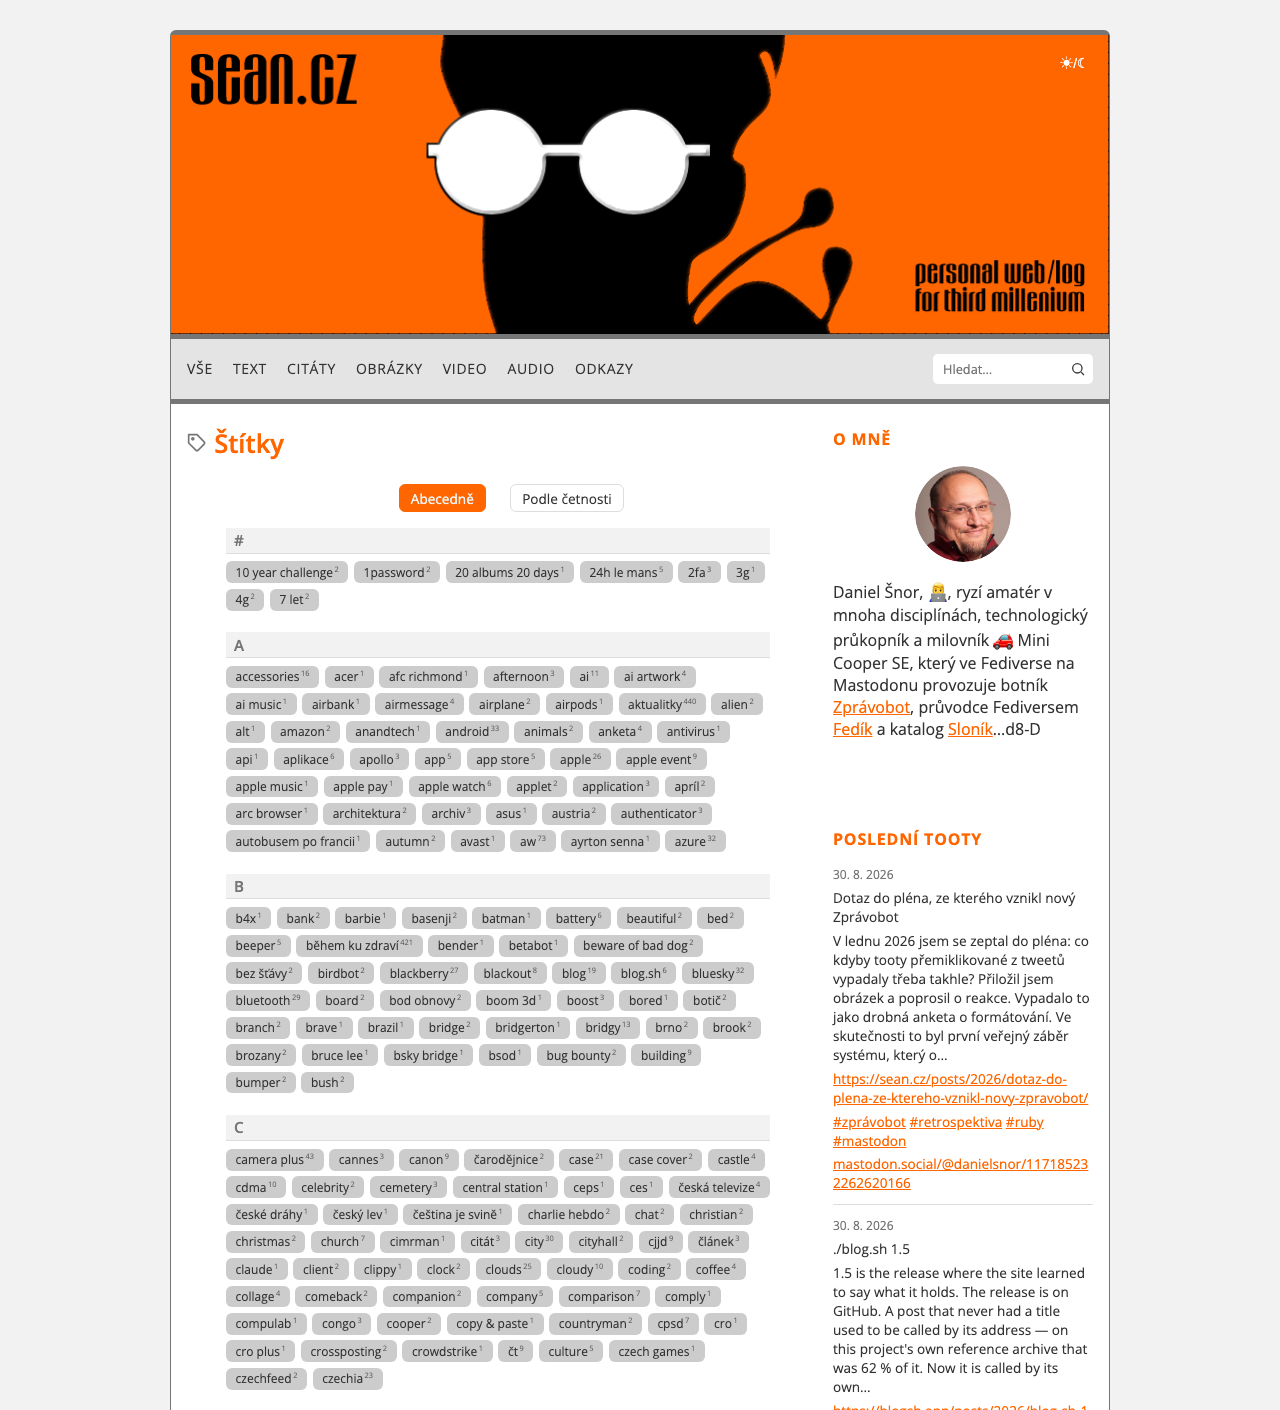
Engine vždy sestavoval stránku pro každý štítek a nikdy nic, co by je ukázalo všechny. Vlastní seznam toho, o čem web píše, žil v browse, nebo v první osmičce ve stats.
Seznam je řazený podle skládaného jména, a to není detail. Ruby řadí řetězce po bajtech, což dává každý štítek s diakritikou až za z: na jednom skutečném archivu je jich dvaapadesát a posledních šest v bajtovém pořadí je školení, školitel, šumava, švihov, želnava, životvkorporátu. Čtenář, který by jeden z nich hledal mezi sirky a sport, by ho nenašel. stats teď skládá také – jedna otázka nemá mít dvě odpovědi.
Každý štítek je pilulka s počtem uvnitř jako horní index, takže zalomený řádek nemůže nechat číslo osamocené vedle špatného jména. Čtenář může přepnout pořadí na podle počtu a volba se pamatuje. Ale stránka je sestavená abecedně a přepínač je skript nad ní: čtenář, jehož prohlížeč ten skript nikdy nespustí, dostane pořadí, které značkování už drží, ne ovládací prvek, který nedělá nic.
Nic k nastavení
Obě stránky jsou vyrobené z příspěvků. Není žádný seznam k udržování, žádná hlavička k doplnění a nic, co by se mohlo rozejít s tím, co web skutečně drží.
Objeví se každý štítek, který má stránku, a žádný jiný. Štítek nesený jen draftem, stránkou nebo příspěvkem mimo výpisy se pod svým příspěvkem kreslí jako plochá pilulka bez odkazu – vypsat ho tady by poslalo čtenáře na 404, a rejstřík, který lže o jedné adrese, je rejstřík, který musíš kontrolovat.
Komentáře